Миграция связки между командами: операционный постмортем и практический фокус
В рамках масштабирования B2B affiliate-операций возникла необходимость переноса связки (трафик + трекер + postback) между двумя командами. Цель — сохранить стабильность источников и минимизировать потерю сигналов при handoff.
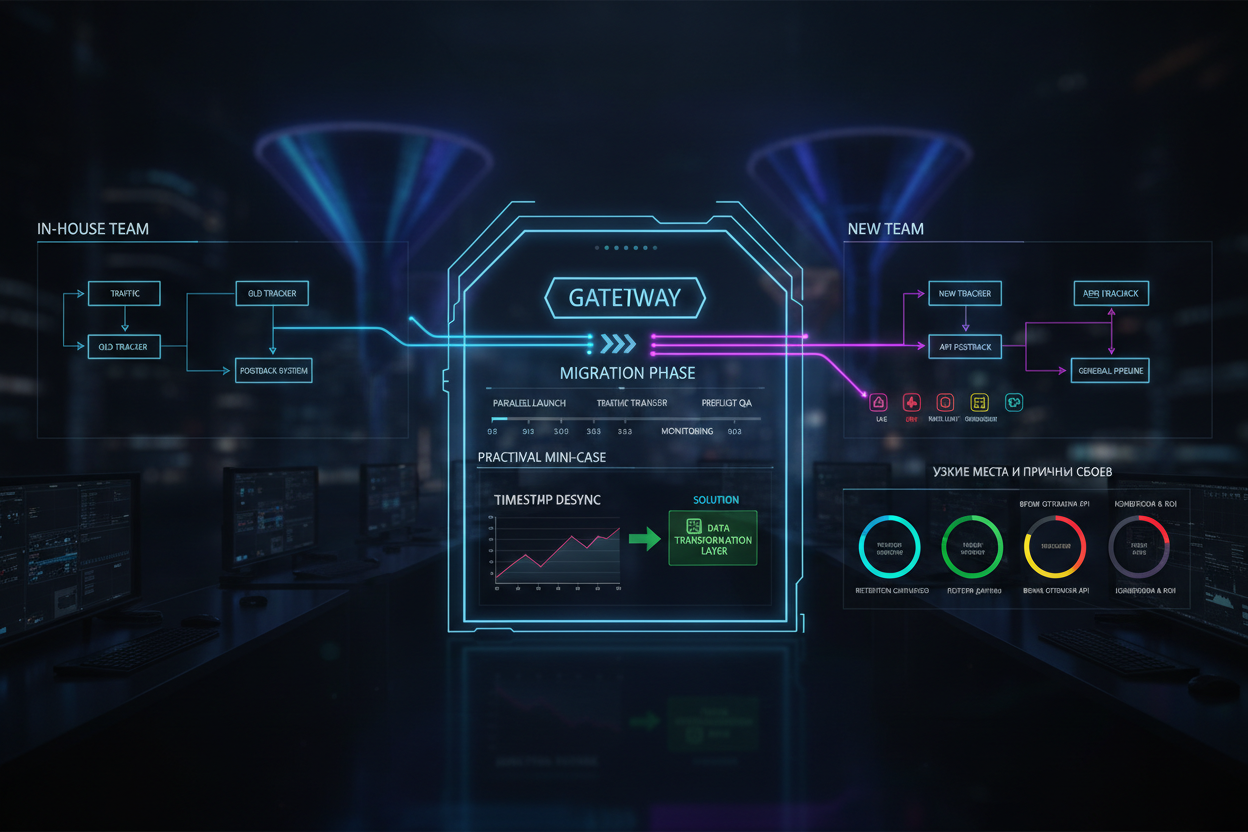
Сетап: архитектура и этапы миграции
- Исходная связка: in-house команда с собственным трекером и postback-системой.
- Целевая связка: новая команда с другим трекером и API postback, интегрированным в общий пайплайн.
- План миграции: параллельный запуск, постепенный перевод трафика, мониторинг KPI.
- Внедрение preflight QA: проверка корректности postback, синхронизация параметров, тестовые прогревы.
Метрики: ключевые показатели для оценки успешности
- Retention сигналов postback — доля успешных конверсий, переданных новой связке.
- Потеря данных — количество пропущенных или дублированных событий.
- Время отклика postback API — latency и стабильность.
- Показатели конверсии и ROI — сравнение до и после миграции.
Узкие места и причины сбоев
- Несогласованность параметров: различия в форматах ID, timestamp, currency приводили к ошибкам сопоставления.
- Отсутствие синхронизации времени: разница в часовых поясах и задержки postback вызывали рассинхронизацию данных.
- Проблемы с API rate limits: новая связка не учитывала ограничения, что приводило к сбоям и потере событий.
- Отсутствие rollback-плана: при первых ошибках не было быстрого отката на старую связку, что усугубляло потери.
- Недостаточный мониторинг: отсутствие real-time alert’ов по ключевым метрикам снижало скорость реакции.
Практический мини-кейс: устранение рассинхронизации postback
При миграции была выявлена рассинхронизация timestamp в postback-событиях, из-за чего часть конверсий не учитывалась новой системой. Решение:
- Внедрение промежуточного слоя трансформации данных с нормализацией времени и форматов.
- Тестирование на тестовом трафике с контролем 100% совпадения событий.
- Автоматизация preflight QA с чеклистом параметров и alert’ами на аномалии.
- Пошаговый rollout с мониторингом retention и откатом при превышении порогов потерь.
Переиспользуемый шаблон для миграции связок
| Этап | Действия | Ключевые проверки | Ответственные |
|---|---|---|---|
| 1. Анализ и подготовка | Согласовать параметры postback, форматы ID, временные зоны | Документ с параметрами, mindmap архитектуры | Технический лидер, аналитик |
| 2. Тестовая интеграция | Настроить тестовый трафик, проверить полноту и корректность событий | 100% совпадение событий, отсутствие ошибок API | DevOps, QA-инженер |
| 3. Preflight QA | Запустить preflight скрипты, настроить alert’ы на аномалии | Автоматические проверки, мониторинг latency | Операторы, инженер поддержки |
| 4. Пошаговый rollout | Постепенно переводить трафик, мониторить метрики, готовить rollback | Порог потерь <5%, своевременный откат при превышении | Менеджер проекта, операторы |
| 5. Постмиграционный мониторинг | Отслеживать стабильность, проводить ретроспективу | Отчеты по retention, latency, ROI | Аналитик, команда поддержки |
Заключение и рекомендации
Миграция связки между командами — критический этап, требующий тщательной подготовки, автоматизации preflight QA и наличия rollback-плана. Ключ к успеху — детальный анализ параметров postback, синхронизация времени и постоянный мониторинг метрик с alert’ами. Использование предложенного шаблона позволяет минимизировать риски и обеспечить стабильность масштабирования B2B affiliate-операций.
Для детальной поддержки и внедрения подобных процессов рекомендуем ознакомиться с нашим списком услуг по техническому сопровождению и оптимизации affiliate-операций.
Edge cases и нестандартные ситуации при миграции связок
- Потеря событий при резких пиках нагрузки: неожиданные всплески трафика могут вызвать превышение лимитов API, даже если в обычном режиме они не достигаются. Рекомендуется предусмотреть буферные очереди и адаптивное throttling.
- Разные часовые пояса и летнее время: автоматическая корректировка timestamp с учётом переходов на летнее/зимнее время, чтобы избежать рассинхронизации.
- Дублирование событий при повторных postback: внедрение идемпотентности на уровне API для предотвращения двойного учёта конверсий.
- Потеря данных при сбоях сети: использование локального кэширования и повторных попыток отправки postback с экспоненциальной задержкой.
Failure modes и анти-паттерны в процессе миграции
- Игнорирование мониторинга latency: приводит к накоплению задержек и ухудшению качества данных без своевременного реагирования.
- Отсутствие четких SLA для postback API: затрудняет выявление и устранение проблем с производительностью.
- Ручное вмешательство без автоматизации: повышает риск ошибок и замедляет реакцию на инциденты.
- Полное отключение старой связки до полной валидации новой: увеличивает риск потери данных и сбоев в бизнес-процессах.
Расширенные QA проверки и автоматизация
- Интеграция end-to-end тестов с симуляцией реального трафика и проверкой консистентности данных между системами.
- Автоматическое сравнение отчетов по конверсиям и ROI с использованием статистических методов для выявления аномалий.
- Настройка alert’ов не только на ошибки, но и на отклонения метрик от базового уровня (например, снижение retention ниже 95%).
- Регулярные ревью и обновление чеклистов preflight QA с учетом новых кейсов и изменений в архитектуре.
Детализированный rollback-план и handoff-риски
- Многоуровневый rollback: возможность отката не только всей связки, но и отдельных компонентов (трафик, postback, трекер) поэтапно.
- Тестирование rollback в условиях продакшена на ограниченной выборке трафика.
- Документирование сценариев handoff с четким описанием точек контроля и ответственных.
- Обучение операторов и техподдержки действиям при rollback и handoff, включая сценарии экстренного реагирования.
Операционные tradeoffs и прикладные решения
- Баланс между скоростью миграции и качеством данных: более медленный rollout снижает риски, но увеличивает время простоя ресурсов.
- Использование feature flags для включения/отключения новых функций postback без перезапуска систем.
- Внедрение централизованного логирования и трассировки для быстрого выявления узких мест и причин сбоев.
- Планирование ресурсов поддержки и мониторинга с учетом пиковых нагрузок и возможных инцидентов.
Рекомендации по дальнейшему развитию процесса миграции
- Регулярное проведение ретроспектив с участием всех команд для выявления и устранения новых рисков.
- Автоматизация анализа логов и метрик с использованием ML для предсказания потенциальных проблем.
- Разработка и поддержка базы знаний с типовыми инцидентами и способами их решения.
- Интеграция с системами управления инцидентами и оповещениями для ускорения реакции.
Edge cases и нестандартные ситуации при миграции связок
- Неожиданные изменения в формате данных от сторонних систем: необходимо предусмотреть адаптивные парсеры и валидацию входящих postback-событий для предотвращения сбоев.
- Параллельная миграция нескольких связок с пересекающимися параметрами: требует строгой изоляции namespace и уникализации ID для предотвращения конфликтов.
- Влияние сетевых задержек и нестабильности на последовательность событий: внедрение буферизации и упорядочивания событий на уровне приемника postback.
- Случаи частичной доступности API новой связки: реализация fallback-механизмов с временным переключением на старую связку или кеширование событий.
Failure modes и анти-паттерны в процессе миграции
- Недооценка влияния временных зон и локализации: приводит к ошибкам в сопоставлении событий и искажению метрик.
- Отсутствие четкой коммуникации между командами: вызывает дублирование усилий и задержки в решении инцидентов.
- Игнорирование необходимости автоматизации тестирования: увеличивает вероятность человеческих ошибок и снижает скорость релизов.
- Полагание на устаревшие логи и метрики без обновления инструментов мониторинга: снижает качество диагностики и реакцию на инциденты.
Расширенные QA проверки и автоматизация
- Внедрение контрактного тестирования API postback для гарантии совместимости между старой и новой связкой.
- Использование симуляторов трафика с вариациями параметров для проверки устойчивости системы к аномалиям.
- Автоматизация анализа логов с применением pattern recognition для выявления скрытых проблем.
- Настройка интеграции с системами оповещений (Slack, PagerDuty) для мгновенного информирования ответственных.
Детализированный rollback-план и handoff-риски
- Разработка сценариев частичного rollback: возможность отката отдельных компонентов без полного возврата к старой связке.
- Проведение dry-run rollback в staging-среде с имитацией реальных условий.
- Определение SLA для handoff-периода с четкими критериями успешности и триггерами отката.
- Обучение команд по сценариям handoff с регулярными тренировками и обновлением документации.
Операционные tradeoffs и прикладные решения
- Выбор между централизованным и децентрализованным управлением postback-событиями с учетом масштабируемости и отказоустойчивости.
- Использование feature toggles для поэтапного включения новых функций с возможностью быстрого отката.
- Интеграция с системами A/B тестирования для оценки влияния миграции на ключевые метрики.
- Планирование ресурсов поддержки с учетом возможных инцидентов в период миграции и handoff.
Рекомендации по дальнейшему развитию процесса миграции
- Внедрение системы непрерывного обучения и обмена знаниями между командами для повышения зрелости процессов.
- Разработка централизованного дашборда с ключевыми метриками и статусами миграции в реальном времени.
- Использование машинного обучения для прогнозирования потенциальных проблем и автоматического предложения решений.
- Регулярное обновление и ревизия шаблонов миграции с учетом накопленного опыта и новых технологий.
Дополнительные edge cases и нестандартные ситуации при миграции связок
- Неожиданные изменения в формате данных от сторонних систем: необходимо предусмотреть адаптивные парсеры и валидацию входящих postback-событий для предотвращения сбоев.
- Параллельная миграция нескольких связок с пересекающимися параметрами: требует строгой изоляции namespace и уникализации ID для предотвращения конфликтов.
- Влияние сетевых задержек и нестабильности на последовательность событий: внедрение буферизации и упорядочивания событий на уровне приемника postback.
- Случаи частичной доступности API новой связки: реализация fallback-механизмов с временным переключением на старую связку или кеширование событий.
Расширенные failure modes и анти-паттерны в процессе миграции
- Недооценка влияния временных зон и локализации: приводит к ошибкам в сопоставлении событий и искажению метрик.
- Отсутствие четкой коммуникации между командами: вызывает дублирование усилий и задержки в решении инцидентов.
- Игнорирование необходимости автоматизации тестирования: увеличивает вероятность человеческих ошибок и снижает скорость релизов.
- Полагание на устаревшие логи и метрики без обновления инструментов мониторинга: снижает качество диагностики и реакцию на инциденты.
Дополнительные расширенные QA проверки и автоматизация
- Внедрение контрактного тестирования API postback для гарантии совместимости между старой и новой связкой.
- Использование симуляторов трафика с вариациями параметров для проверки устойчивости системы к аномалиям.
- Автоматизация анализа логов с применением pattern recognition для выявления скрытых проблем.
- Настройка интеграции с системами оповещений (Slack, PagerDuty) для мгновенного информирования ответственных.
Детализированный rollback-план и handoff-риски: дополнительные аспекты
- Разработка сценариев частичного rollback: возможность отката отдельных компонентов без полного возврата к старой связке.
- Проведение dry-run rollback в staging-среде с имитацией реальных условий.
- Определение SLA для handoff-периода с четкими критериями успешности и триггерами отката.
- Обучение команд по сценариям handoff с регулярными тренировками и обновлением документации.
Операционные tradeoffs и прикладные решения: дополнительные рекомендации
- Выбор между централизованным и децентрализованным управлением postback-событиями с учетом масштабируемости и отказоустойчивости.
- Использование feature toggles для поэтапного включения новых функций с возможностью быстрого отката.
- Интеграция с системами A/B тестирования для оценки влияния миграции на ключевые метрики.
- Планирование ресурсов поддержки с учетом возможных инцидентов в период миграции и handoff.
Рекомендации по дальнейшему развитию процесса миграции: новые идеи
- Внедрение системы непрерывного обучения и обмена знаниями между командами для повышения зрелости процессов.
- Разработка централизованного дашборда с ключевыми метриками и статусами миграции в реальном времени.
- Использование машинного обучения для прогнозирования потенциальных проблем и автоматического предложения решений.
- Регулярное обновление и ревизия шаблонов миграции с учетом накопленного опыта и новых технологий.
Практический план внедрения
Чтобы перейти от теории к результату, зафиксируйте целевую метрику и горизонт проверки: конверсия, стоимость лида, скорость обработки, доля ошибок. Для темы «Миграция связки между командами: операционный постмортем и практический фокус» важно заранее определить, какой сигнал считается успехом и какой порог запускает корректировку процесса.
Разбейте внедрение на короткие итерации: подготовка данных, ограниченный запуск, валидация гипотез, расширение охвата. На каждом шаге ведите журнал решений и причин отклонений, чтобы команда могла быстро воспроизводить результат и не терять контекст при передаче задач между ролями.
Добавьте операционный чеклист: входные условия, критерии качества, допустимые риски, план отката, ответственные по SLA. Такой формат снижает вероятность «тихих» регрессий и помогает масштабировать процесс без роста ручной нагрузки.
Параллельно настройте мониторинг: отдельные события для бизнес-метрик и технической стабильности. Если метрика улучшается, но растёт латентность или увеличивается доля ошибок, фиксируйте компромисс и корректируйте конфигурацию до балансного режима.
Контроль качества перед масштабированием
- Проверка полноты входных данных и корректности обогащения.
- Сравнение результата с базовой линией до внедрения.
- Аудит edge-case сценариев и правил эскалации.
- Документирование итоговых порогов и регламентов поддержки.
После стабилизации переведите решение в регулярный цикл улучшений: еженедельный разбор аномалий, обновление порогов и пересмотр приоритетов под текущие бизнес-цели. Это позволяет поддерживать предсказуемый рост качества без резких колебаний в продакшене.
Чтобы перейти от теории к результату, зафиксируйте целевую метрику и горизонт проверки: конверсия, стоимость лида, скорость обработки, доля ошибок. Для темы «Миграция связки между командами: операционный постмортем и практический фокус» важно заранее определить, какой сигнал считается успехом и какой порог запускает корректировку процесса.
Разбейте внедрение на короткие итерации: подготовка данных, ограниченный запуск, валидация гипотез, расширение охвата. На каждом шаге ведите журнал решений и причин отклонений, чтобы команда могла быстро воспроизводить результат и не терять контекст при передаче задач между ролями.